🤩 Marvell verhoogt outlook fors: Wat een mooi aandeel nog steeds goedkoop
Wil je alle artikelen kunnen lezen en elke podcast beluisteren? Neem dan een abonnement en krijg toegang tot alle artikelen en de database met duizenden berichten.
■ Marvell verhoogt de omzetverwachting voor boekjaar 2028 van ongeveer $18 miljard naar circa $20 miljard en presenteert voor boekjaar 2031 een omzetkader van $70 miljard tot $90 miljard. Vanaf FY28 impliceert dat nog altijd ongeveer 52% tot 65% samengestelde jaarlijkse groei, waarmee management duidelijk maakt dat het rekent op een fundamenteel grotere positie binnen AI-infrastructuur.
■ Custom silicon wordt een van de belangrijkste groeimotoren. Voor boekjaar 2029 verwacht Marvell inmiddels meer dan $12 miljard omzet uit deze activiteit, terwijl de werkelijke economische kans groter is doordat dezelfde XPU-programma’s ook vraag kunnen creëren naar netwerkinterfaces, memory connectivity, storage, security en andere XPU-attach producten.
■ De technische bottleneck binnen AI verschuift steeds verder van alleen rekenkracht naar data movement, geheugenbandbreedte, latency, power en interconnect. Juist op dat snijvlak komen de activiteiten van Marvell in custom compute, SerDes, switching, optics en storage samen.
■ De door Marvell geschetste totale adresseerbare markt van ongeveer $400 miljard moet niet als automatische omzet worden beschouwd. De veel belangrijkere vraag is hoeveel Marvell-content per XPU, per rack en uiteindelijk per cluster kan worden geplaatst, omdat juist daar een model kan ontstaan waarin de omzet sneller groeit dan alleen het aantal accelerators.
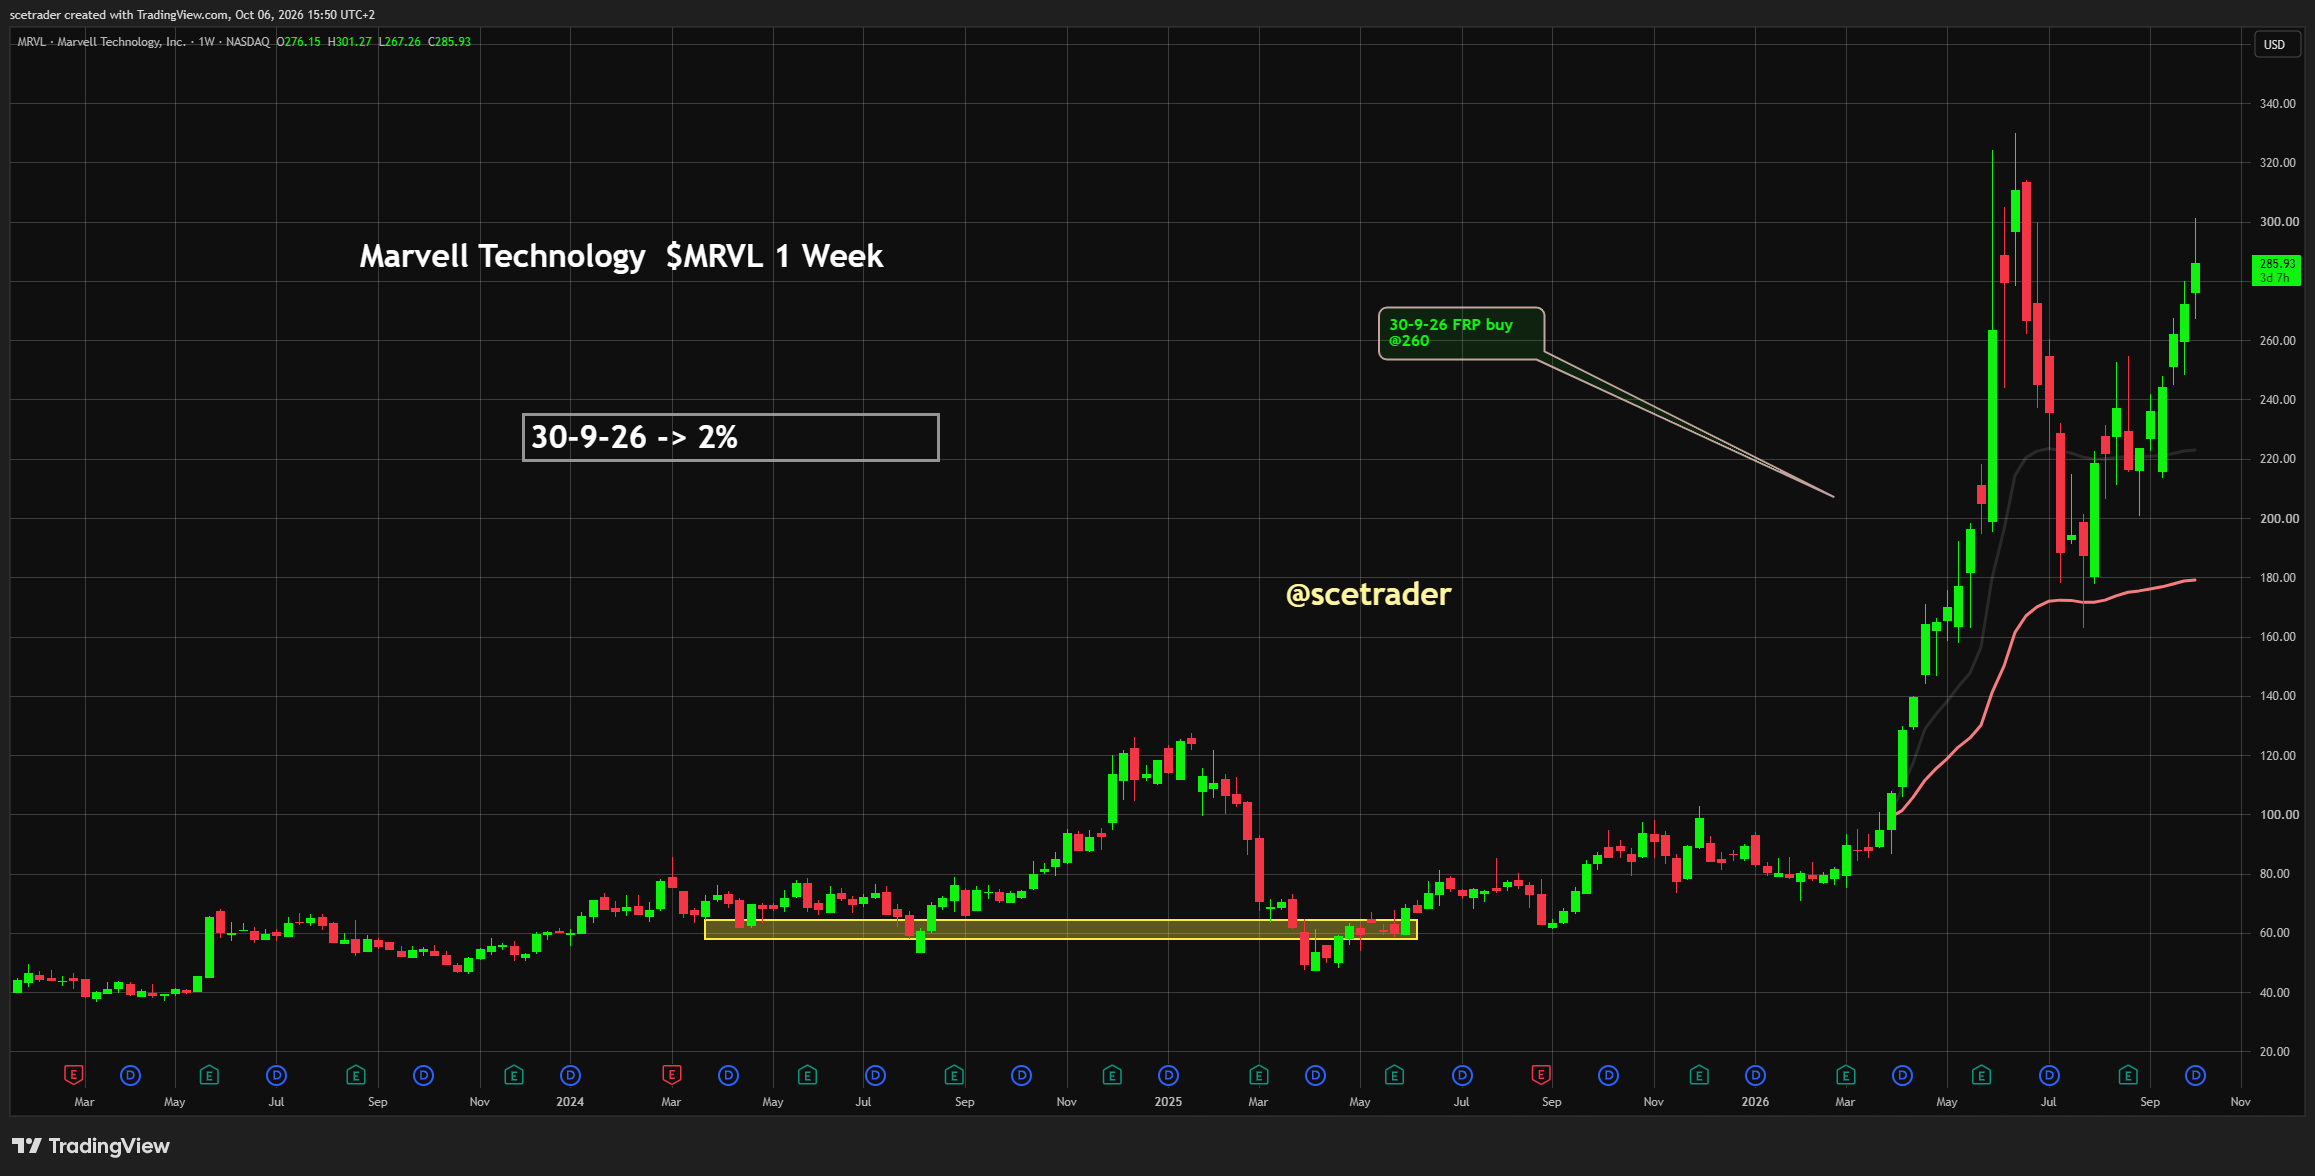
■ Wij hebben Marvell onlangs gekocht en de Investor Day versterkt onze bullish visie duidelijk. Zelfs wanneer het bedrijf in boekjaar 2031 ruim onder de bovenkant van $90 miljard uitkomt, kan de combinatie van custom silicon, XPU-attach en connectivity een veel grotere winstbasis creëren dan de markt enkele jaren geleden voor mogelijk hield. Zie ook de database over Marvell.
Investment View
Wij hebben Marvell onlangs gekocht en zien de Investor Day als een duidelijke versterking van de oorspronkelijke investment case. De verhoging van de omzetverwachting voor boekjaar 2028 naar ongeveer $20 miljard is belangrijk, maar de echte verandering zit volgens ons in de manier waarop het bedrijf zijn plaats binnen de architectuur van een AI-datacenter probeert uit te breiden. Marvell wil niet meer worden gewaardeerd als een leverancier van afzonderlijke netwerk- en storagechips, maar als een onderneming die meerdere cruciale siliciumlagen rond dezelfde accelerator kan leveren.
Wil je alle artikelen kunnen lezen en elke podcast beluisteren? Neem dan een abonnement en krijg toegang tot alle artikelen en de database met duizenden berichten.
Die verschuiving verandert de economische waarde van een design win. Wanneer Marvell alleen een custom XPU levert, is de omzet vooral afhankelijk van het aantal processors en de waarde per processor. Wanneer dezelfde klantrelatie vervolgens ook netwerkinterfaces, memory controllers, storage controllers, switches, high-speed SerDes en andere attach-producten oplevert, ontstaat een veel bredere omzetstroom rond hetzelfde compute-platform. Daarmee kan de content per accelerator stijgen, zelfs wanneer de groei van het aantal accelerators op enig moment begint af te zwakken.
Onze visie blijft daarom nadrukkelijk bullish, maar niet omdat wij $90 miljard omzet in boekjaar 2031 als zekerheid beschouwen. Wij willen vooral zien dat Marvell drie dingen bewijst: dat de brug richting circa $20 miljard omzet in FY28 daadwerkelijk wordt gesloten, dat custom silicon bij meerdere klanten en over meerdere programma’s opschaalt en dat XPU-attach een materiële omzet- en winstbijdrage begint te leveren. Wanneer die drie onderdelen samenkomen, kan de economische waarde van Marvell veel sneller stijgen dan een traditioneel halfgeleidermodel suggereert.
Wil je alle artikelen kunnen lezen en elke podcast beluisteren? Neem dan een abonnement en krijg toegang tot alle artikelen en de database met duizenden berichten.
Marvell verhoogt niet alleen de outlook, maar verandert de schaal van de onderneming
Marvell realiseerde in boekjaar 2026 ongeveer $8,2 miljard omzet en schetst nu een traject waarin dat bedrag richting ongeveer $20 miljard in boekjaar 2028 kan stijgen. Daarbovenop presenteert management een omzetkader van $70 miljard tot $90 miljard voor boekjaar 2031. Vanaf $20 miljard betekent de onderkant van dat kader nog altijd circa 52% jaarlijkse groei en de bovenkant ongeveer 65%, een tempo dat voor een onderneming van deze omvang uitzonderlijk is.
Die groei kan onmogelijk alleen uit normale uitbreiding van bestaande networking- en storageactiviteiten komen. Om de onderkant van het FY31-kader te benaderen, moeten meerdere grote custom compute-programma’s tegelijk in volume komen, moet Marvell meer producten rond iedere XPU verkopen en moet connectivity-content sneller blijven stijgen dan de algemene groei van AI-capex. De Investor Day is daarmee feitelijk een verklaring dat management verwacht dat Marvell binnen iedere nieuwe generatie AI-systemen een groter gedeelte van de totale semiconductor content kan innemen.
Juist daarom vinden wij de verhoging naar circa $20 miljard in FY28 zo belangrijk. De $70–90 miljard voor FY31 is spectaculair, maar ligt ver genoeg weg om afhankelijk te zijn van veel variabelen die vandaag nog niet volledig zichtbaar zijn. De FY28-doelstelling ligt veel dichterbij en kan de komende kwartalen worden getoetst aan bookings, productramps, wafer commitments, klantconcentratie en omzet uit datacenters. Wanneer die brug overtuigend wordt gesloten, wordt het veel grotere scenario automatisch geloofwaardiger.
De echte hefboom zit niet alleen in XPUs, maar in content per XPU
Veel analyses van custom silicon beginnen en eindigen bij het aantal accelerators dat een leverancier kan winnen. Voor Marvell is dat volgens ons een te beperkte benadering, omdat iedere XPU deel uitmaakt van een veel groter systeem waarin data tussen compute, geheugen, storage en netwerk moet bewegen. Naarmate accelerators krachtiger worden, neemt de hoeveelheid infrastructuur die nodig is om die processors volledig te benutten eveneens toe.
Dat betekent dat de relevante variabele niet alleen het aantal geproduceerde XPUs is, maar de totale Marvell-content per XPU. Wanneer een nieuwe generatie bijvoorbeeld meer high-speed links, grotere memory bandwidth en complexere netwerkinterfaces nodig heeft, kan de semiconductor content per accelerator stijgen zonder dat het aantal accelerators even hard hoeft te groeien. Dit is precies het soort multiplicatieve effect dat een omzetcurve veel steiler kan maken dan een eenvoudige analyse op basis van units.
Voor institutionele beleggers is dit belangrijk omdat het de afhankelijkheid van één enkele productcategorie verlaagt. Een custom compute-programma kan een ingang vormen naar meerdere aanvullende sockets en daarmee de lifetime value van een klantrelatie sterk verhogen. Wanneer Marvell erin slaagt die attach-strategie systematisch uit te voeren, ontstaat een veel bredere inkomstenbasis dan alleen de centrale processor.
XPU-attach kan de onderschatte winstpool worden
Het begrip XPU-attach verdient daarom veel meer aandacht dan het meestal krijgt. Rond een moderne accelerator bevinden zich netwerkinterfaces, memory controllers, storage controllers, securityfuncties, fabric controllers en verschillende vormen van high-speed I/O. Iedere functie vertegenwoordigt afzonderlijke semiconductor content en kan bovendien bij iedere nieuwe generatie complexer en duurder worden.
De economische kans ontstaat doordat Marvell op meerdere van deze gebieden al technologie bezit. Een klant die Marvell inschakelt voor custom compute kan daardoor dezelfde leverancier gebruiken voor delen van de connectivity- en memory-architectuur. Dat verlaagt de integratierisico’s voor de klant en vergroot tegelijkertijd de hoeveelheid Marvell-content binnen hetzelfde systeem. Vanuit het perspectief van Marvell is dit aantrekkelijker dan uitsluitend concurreren om één socket met één ASP.
Deze attach-logica kan bovendien belangrijker worden naarmate AI-systemen heterogener worden. GPU’s, custom accelerators, CPU’s, memory pools en storage accelerators moeten steeds vaker als één logisch systeem functioneren. Hoe heterogener de compute-architectuur wordt, hoe groter de behoefte aan interfaces die al deze onderdelen efficiënt met elkaar laten communiceren. Juist daar kan Marvell meer waarde creëren dan een eenvoudige vergelijking van acceleratoraantallen doet vermoeden.
Custom silicon wordt een platformrelatie en geen afzonderlijk ASIC-project
De verwachting dat custom silicon in boekjaar 2029 meer dan $12 miljard omzet kan genereren geeft aan hoe belangrijk dit onderdeel wordt. Een dergelijke schaal is moeilijk te realiseren met één enkele klant of één generatie en impliceert dat management rekent op meerdere programma’s die tegelijkertijd richting grote volumes bewegen. Dat is essentieel, omdat custom silicon pas echt aantrekkelijk wordt wanneer design wins zich vertalen naar terugkerende generaties.
Hyperscalers hebben goede redenen om meer silicium zelf te specificeren. Wanneer een workload groot en voorspelbaar genoeg wordt, kan een custom accelerator worden geoptimaliseerd voor specifieke datatypes, memory access patterns, software en power envelopes. Een kleine verbetering in prestaties per watt kan op hyperscale niveau miljarden dollars aan infrastructuur beïnvloeden, waardoor de economische prikkel om eigen architecturen te ontwikkelen steeds groter wordt.
Tegelijk is het ontwerpen van een succesvolle custom chip uitzonderlijk complex. Het gaat niet alleen om compute logic, maar ook om physical design, timing closure, high-speed I/O, memory interfaces, power delivery, thermiek, packaging en uiteindelijk produceerbaarheid op een geavanceerde node. Een succesvolle leverancier wordt daardoor diep geïntegreerd in de roadmap van de klant. Wanneer de eerste generatie goed presteert, neemt de kans toe dat dezelfde partner ook bij de volgende architectuur wordt betrokken.
Engineering velocity wordt een concurrentievoordeel
In custom silicon is technische kwaliteit alleen niet voldoende. Een chip die zes maanden te laat arriveert kan commercieel veel minder waard zijn, omdat AI-roadmaps tegenwoordig extreem snel bewegen en hyperscalers hun datacenters rond vooraf geplande generaties bouwen. Time-to-market wordt daardoor een directe economische variabele.
Wil je alle artikelen kunnen lezen en elke podcast beluisteren? Neem dan een abonnement en krijg toegang tot alle artikelen en de database met duizenden berichten.
Marvell meldde dat een nieuw design binnen zestig dagen naar ongeveer 30.000 cores kon worden opgeschaald en in minder dan negen maanden tape-out bereikte. Voor een buitenstaander lijkt dat vooral een operationeel detail, maar voor een hyperscaler is dit cruciaal. Hoe sneller een leverancier van architectuur naar first silicon kan bewegen zonder concessies te doen aan kwaliteit, hoe groter de kans dat een klant zijn eigen productplanning haalt.
Daar kan bovendien schaalvoordeel ontstaan. Wanneer Marvell herbruikbare IP, verificatieprocessen, packagingkennis en physical-design workflows over verschillende programma’s kan inzetten, hoeft engineering niet lineair mee te groeien met omzet. Dat is een belangrijk onderdeel van de toekomstige operating leverage, omdat de omzet dan sneller kan stijgen dan de kosten van de engineeringorganisatie.
De bottleneck verschuift van FLOPS naar data movement
De eerste fase van de AI-investeringsgolf draaide vooral om de beschikbaarheid van compute. De volgende fase draait steeds meer om de vraag hoe efficiënt die compute kan worden benut. Een accelerator kan op papier een enorme hoeveelheid berekeningen uitvoeren, maar die theoretische capaciteit heeft weinig waarde wanneer weights, activations en intermediate results niet snel genoeg beschikbaar zijn.
Daarom worden memory bandwidth en interconnect bandwidth steeds belangrijker. Binnen een accelerator moet data tussen compute en geheugen bewegen, binnen een server moeten verschillende processors communiceren en binnen een groot cluster moeten duizenden of zelfs tienduizenden accelerators als één systeem functioneren. Iedere schaalstap verhoogt de hoeveelheid data movement en maakt latency en congestion belangrijker.
Daarmee wordt networking steeds meer onderdeel van compute zelf. Wanneer een fabric onvoldoende bandbreedte heeft, daalt de accelerator utilization en daarmee het rendement op extreem dure AI-hardware. Voor Marvell is dat fundamenteel positief, omdat het bedrijf niet noodzakelijk iedere accelerator hoeft te winnen zolang het een groter deel kan leveren van de infrastructuur die al die accelerators met elkaar verbindt.
SerDes is geen detail maar een fundamentele asset
High-speed SerDes vormt de fysieke basis van een groot deel van moderne data-infrastructuur. De technologie zet parallelle data om in zeer snelle seriële stromen en reconstrueert die aan de andere kant, maar bij snelheden van honderden gigabits per lane wordt dit een buitengewoon complex probleem van signaalintegriteit, jitter, equalization, bit error rate en energieverbruik.
Naarmate lane rates stijgen, wordt iedere volgende generatie technisch moeilijker. Het kanaalverlies neemt toe, de timingmarges worden kleiner en de benodigde signal processing wordt zwaarder, terwijl hyperscalers tegelijkertijd meer bandbreedte en minder energie per bit eisen. Een sterke SerDes-portefeuille wordt daardoor niet alleen een technisch voordeel, maar een economische asset die bepaalt hoeveel data tegen welk energieverbruik door het systeem kan worden verplaatst.
Voor beleggers is vooral de maatstaf picojoules per bit belangrijk. Een verschil van slechts enkele picojoules lijkt op componentniveau minimaal, maar binnen een cluster waarin enorme hoeveelheden data permanent worden verplaatst, kan dit op systeemniveau in een zeer groot vermogensverschil resulteren. Een efficiëntere interface creëert daardoor indirect ruimte voor extra compute binnen hetzelfde totale power budget.
Van 800G naar 1.6T verandert de hele fysieke laag
De overgang van 800G naar 1.6T moet niet worden gezien als simpelweg twee keer zoveel netwerkcapaciteit. Hogere datarates stellen veel strengere eisen aan DSP’s, modulatie, equalization, lasers, thermiek en packaging, terwijl de totale power per poort niet in hetzelfde tempo mag stijgen. De industrie moet dus meer data verplaatsen terwijl de energie per bit juist omlaag moet.
Dat creëert een nieuwe vervangingscyclus over de volledige signal chain. Switches, DSP’s, SerDes en optical components moeten allemaal geschikt worden gemaakt voor hogere snelheden, waardoor een nieuwe generatie netwerktechnologie op meerdere plaatsen tegelijk semiconductor content creëert. De omzetkans voor Marvell wordt daardoor bepaald door zowel meer AI-nodes als meer waarde per verbinding.
Dezelfde logica geldt wanneer de industrie uiteindelijk verder opschuift richting 3.2T. Naarmate port speeds stijgen, neemt de technische moeilijkheid sneller toe dan de nominale bandbreedte alleen suggereert. Dat kan de waarde van bewezen high-speed IP verhogen en tegelijkertijd de toetredingsdrempel voor kleinere leveranciers vergroten.
Scale-up en scale-out vragen verschillende technologie
AI-networking bestaat niet uit één homogene markt. Scale-up verbindt accelerators binnen een zeer strak compute-domain en vereist extreem lage latency en hoge bandbreedte, omdat meerdere chips zich zoveel mogelijk als één logische processor moeten gedragen. Scale-out verbindt grotere groepen servers, racks en pods en stelt andere eisen aan routing, congestion management, topology en reach.
Voor scale-up wordt de fabric steeds meer een verlengstuk van de processorarchitectuur. Voor scale-out zijn Ethernet, optical connectivity en zeer grote switches essentieel om accelerator utilization hoog te houden over grotere afstanden. Beide gebieden groeien door dezelfde AI-golf, maar de technische bottlenecks en economische modellen verschillen.
Voor Marvell is het aantrekkelijk dat de onderneming op verschillende lagen aanwezig kan zijn. Custom compute, high-speed SerDes, switching en optics kunnen binnen dezelfde klantarchitectuur op verschillende niveaus worden ingezet. Daarmee kan Marvell zowel aan de uitbreiding van de compute-domain als aan de verbinding tussen verschillende domains verdienen.
Power wordt de nieuwe valuta van AI-infrastructuur
De economische beperking van AI-datacenters verschuift steeds vaker van kapitaal naar beschikbare elektriciteit. Hyperscalers kunnen bereid zijn tientallen miljarden dollars te investeren, maar wanneer een locatie slechts een bepaald aantal megawatt kan ontvangen en koelen, wordt iedere watt een schaarse resource. Daardoor krijgt efficiëntie van networking en data movement een veel grotere economische waarde.
Een watt die door een switch, DSP of retimer wordt gebruikt, kan niet meer worden ingezet voor compute. Dat betekent dat een efficiëntere interface indirect meer accelerators mogelijk kan maken binnen hetzelfde gebouw. Het verschil tussen twee connectivity-oplossingen moet daarom niet alleen worden gemeten in componentprijs, maar in de totale hoeveelheid compute die binnen een gegeven power envelope mogelijk wordt.
Dit kan de waardering van hoogwaardige connectivity veranderen. Producten die aantoonbaar lagere energie per bit leveren, zijn geen commodity wanneer ze direct bepalen hoeveel compute een hyperscaler uit dezelfde elektrische infrastructuur kan halen. Voor Marvell kan dit een structurele bron van pricing power en differentiatie worden.
Optics schuift steeds dichter richting de processor
Wil je alle artikelen kunnen lezen en elke podcast beluisteren? Neem dan een abonnement en krijg toegang tot alle artikelen en de database met duizenden berichten.
Elektrische verbindingen blijven uitstekend over korte afstanden, maar de fysica wordt steeds ongunstiger wanneer snelheid en afstand tegelijkertijd toenemen. Signaalverlies stijgt, equalization wordt complexer en het energieverbruik loopt op. Daardoor schuift optical connectivity steeds verder van de rand van het netwerk richting de compute-laag.
Die ontwikkeling kan uiteindelijk leiden tot meer near-package en co-packaged optical architecturen. In zo’n systeem wordt optics geen losse netwerkmodule meer, maar een integraal onderdeel van de manier waarop compute, memory en switches met elkaar communiceren. Dat vergroot de strategische waarde van optical DSP’s, photonics en de interfaces daaromheen.
Voor Marvell is dit belangrijk omdat het bedrijf al diep in high-speed connectivity zit. Wanneer optics structureel dichter naar de XPU beweegt, kan de hoeveelheid Marvell-content per compute-node opnieuw toenemen. Daarmee ontstaat nog een extra route om sneller te groeien dan alleen het aantal processors.
Chiplets veranderen de economie van geavanceerde processors
Naarmate AI-processors groter worden, loopt een monolithische die tegen fysieke en economische grenzen aan. Grotere dies hebben een lagere kans om volledig foutloos uit de wafer te komen en worden daarnaast begrensd door reticle limits. Chiplets bieden een manier om functies over meerdere kleinere dies te verdelen en verschillende onderdelen zelfs op verschillende productieprocessen te bouwen.
Dat verbetert potentieel de yield-economie, maar verplaatst een deel van het technische probleem naar de verbinding tussen de chiplets. Die-to-die links moeten extreem veel data met lage latency en weinig energie transporteren. De package wordt daardoor een systeem op zichzelf, waarin connectivity bijna net zo belangrijk is als de afzonderlijke dies.
Voor Marvell creëert dat twee kansen tegelijk. Custom compute kan complexere ontwerpen gebruiken zonder alles in één gigantische die te plaatsen, terwijl high-speed interface-IP nodig is om die chiplets als één processor te laten functioneren. De grens tussen compute en connectivity vervaagt daardoor ook binnen het package zelf.
Yield wordt een financiële variabele
Yield wordt bij advanced-node custom silicon vaak behandeld als een technisch detail, maar voor beleggers is het een directe winstvariabele. Wanneer een grote 3nm- of 2nm-die slechts enkele procentpunten slechter yieldt dan gepland, stijgt de effectieve kostprijs per goede chip sterk. Bij miljoenen units kan dat verschil honderden miljoenen dollars aan economics beïnvloeden.
Daar komt bij dat onvoldoende yield een productramp kan vertragen. Voor een hyperscaler die zijn datacenter, software en powerinfrastructuur al rond een nieuwe processor heeft gepland, is een vertraging veel duurder dan alleen de extra waferkosten. Betrouwbare execution krijgt daardoor een zeer hoge economische waarde.
Dit is een belangrijk onderdeel van onze bullish visie, maar ook een belangrijke test. Marvell moet niet alleen design wins blijven aankondigen; het moet bewijzen dat die designs op geavanceerde nodes met voldoende yield en op tijd naar volume kunnen worden gebracht. Uiteindelijk bepaalt die conversie hoeveel van de enorme TAM werkelijk in omzet verandert.
Advanced packaging wordt even belangrijk als de wafer
De moderne AI-processor is steeds minder één enkele chip. Compute-dies, HBM, I/O-dies en andere functies moeten binnen een complex package met elkaar worden verbonden. Packaging bepaalt daardoor mede de bandbreedte, thermiek, power delivery en uiteindelijk de prestaties van het hele systeem.
Dat creëert een nieuwe bottleneck. Zelfs wanneer wafer yield uitstekend is, kan de uiteindelijke package yield onvoldoende zijn of kan capaciteit voor geavanceerde packaging beperkt blijven. Voor custom silicon is supply-chain execution daarmee een integraal onderdeel van de waardepropositie.
Een hyperscaler wil niet alleen weten of een chip technisch werkt, maar ook of miljoenen exemplaren op het juiste moment kunnen worden geleverd. Marvell moet daarom niet alleen beschikken over goede IP, maar ook over voldoende toegang tot foundry- en packagingcapaciteit om grote ramps te ondersteunen. Naarmate de omzetdoelstellingen hoger worden, wordt dit operationele onderdeel steeds belangrijker.
HBM en memory bandwidth bepalen hoeveel compute werkelijk bruikbaar is
AI-workloads zijn steeds sterker afhankelijk van geheugen. Een accelerator die moet wachten op data gebruikt kapitaal en elektriciteit zonder de theoretische compute-capaciteit daadwerkelijk te benutten. Daardoor wordt HBM-bandwidth net zo belangrijk als het aantal compute units op de processor.
Tegelijk groeit de behoefte aan memory capacity. Grote modellen, langere context windows en agentic workloads kunnen enorme hoeveelheden data actief houden, waardoor niet alles economisch in het snelste geheugen naast de accelerator kan worden geplaatst. Er ontstaat daarom een steeds complexere hiërarchie van HBM, DRAM, pooled memory en storage.
Dat vergroot opnieuw de behoefte aan controllers en connectivity. Data moet efficiënt tussen verschillende lagen worden verplaatst en de architectuur moet voorkomen dat dure compute stilvalt. Voor Marvell is dit aantrekkelijk omdat memory, storage en networking hierdoor steeds dichter naar elkaar toe groeien en meerdere onderdelen van de portefeuille in dezelfde systeemarchitectuur relevant kunnen worden.
Omzet is niet genoeg: de kwaliteit van de omzet wordt beslissend
Wil je alle artikelen kunnen lezen en elke podcast beluisteren? Neem dan een abonnement en krijg toegang tot alle artikelen en de database met duizenden berichten.
Voor een institutionele belegger is $70 miljard tot $90 miljard omzet indrukwekkend, maar omzet alleen creëert geen aandeelhouderswaarde. De echte vraag is welke brutowinst, operationele winst en vrije kasstroom bij die omzet horen. Vooral bij custom silicon moet zorgvuldig worden gekeken naar de verhouding tussen volume, ASP, NRE, gross margin en de engineeringkosten die nodig zijn om een programma te ondersteunen.
Custom producten kunnen een lager brutomargepercentage hebben dan zeer gedifferentieerde merchant silicon, maar toch veel meer absolute brutowinst genereren. Daarom is een eventuele daling van het margepercentage niet automatisch negatief wanneer gross profit en operating income veel sneller stijgen. Het belangrijkste is hoeveel incrementele winst iedere extra dollar omzet uiteindelijk produceert.
Daar ligt een belangrijke toekomstige test voor Marvell. Wanneer omzet sterk groeit terwijl R&D en andere operationele kosten veel minder snel toenemen, ontstaat krachtige operating leverage. Wanneer iedere nieuwe klant bijna evenveel extra engineeringcapaciteit vraagt als de vorige, wordt die leverage zwakker en zal de markt een lagere multiple aan de groei toekennen.
NRE, ASP en wafer volume bepalen de economische kwaliteit van custom silicon
Een custom design win is nog geen productieomzet. Tussen een eerste overeenkomst en grote wafervolumes zitten architecture freeze, verification, physical design, tape-out, silicon bring-up, qualification en volledige systeemvalidatie. Iedere stap bevat technisch en commercieel risico.
NRE kan een deel van de ontwikkelingskosten compenseren, maar de grote economische waarde ontstaat pas wanneer een product in volume gaat. Daardoor moeten beleggers onderscheid maken tussen aangekondigde wins en bewezen production ramps. Vooral in een sterke AI-markt kan de waardering snel vooruitlopen op omzet die technisch nog meerdere stappen van massaproductie verwijderd is.
Aan de andere kant kan omzet na qualification zeer snel versnellen. Wanneer een hyperscaler eenmaal besluit honderdduizenden of miljoenen chips uit te rollen, gaat een programma in korte tijd van engineering naar miljarden dollars aan productomzet. Dat verklaart waarom de custom silicon-groei van Marvell de komende jaren sterk niet-lineair kan verlopen.
De $400 miljard TAM moet kritisch worden gelezen
De door Marvell genoemde totale adresseerbare markt van ongeveer $400 miljard is indrukwekkend, maar een TAM is geen forecast. De relevante analyse begint pas wanneer de markt wordt opgesplitst in custom compute, interconnect, switching, storage en overige attach-producten. Vervolgens moet worden bepaald waar Marvell een technologisch voordeel heeft en welk marktaandeel realistisch kan worden gewonnen.
Het bullish element zit daarom niet in het absolute TAM-getal. Het zit in de mogelijkheid dat verschillende delen van die TAM binnen dezelfde klantarchitectuur met elkaar verbonden raken. Wanneer Marvell alleen custom compute wint, blijft de kans groot maar duidelijk afgebakend. Wanneer dezelfde compute-relatie ook networking, storage en memory-connectivity oplevert, stijgt de potentiële omzet per klant veel sneller.
Dat is de belangrijkste reden waarom wij de Investor Day positiever interpreteren dan alleen een hogere omzetprognose. Management beschrijft feitelijk een strategie waarbij Marvell steeds meer van de totale semiconductor wallet van een hyperscaler wil pakken.
Broadcom blijft de referentie, maar Marvell hoeft Broadcom niet te vervangen
Broadcom blijft de belangrijkste referentie voor de waardering van custom AI silicon. Het bedrijf beschikt over enorme schaal, zeer sterke relaties met hyperscalers, bewezen execution en belangrijke technologie in networking en SerDes. Marvell bevindt zich nog niet op hetzelfde niveau van bewezen commerciële schaal.
Dat betekent echter niet dat Marvell Broadcom volledig moet verdringen voordat de investment case werkt. De totale markt wordt groot genoeg om meerdere leveranciers zeer omvangrijke omzet te laten realiseren, terwijl hyperscalers bovendien belang hebben bij diversificatie van leveranciers, architecturen en IP. Verschillende ondernemingen kunnen zelfs binnen dezelfde infrastructuur verschillende sockets winnen.
De echte wedstrijd gaat daarom om wallet share binnen de volledige architectuur. Wanneer Marvell bestaande custom compute-relaties kan gebruiken om meer connectivity-, memory- en storageproducten te verkopen, kan de omzet per klant sterk stijgen zonder dat het bedrijf overal marktleider hoeft te worden.
NVIDIA hoeft niet te verliezen voordat Marvell kan winnen
De opkomst van custom silicon wordt vaak neergezet als een directe bedreiging voor NVIDIA, maar die tegenstelling is te eenvoudig. De totale AI-markt kan groot genoeg worden om zowel NVIDIA-platforms als verschillende custom XPU-architecturen sterk te laten groeien. Verschillende workloads vragen bovendien verschillende oplossingen.
Voor Marvell kan die heterogeniteit juist aantrekkelijk zijn. Hoe meer compute-architecturen er ontstaan, hoe groter de behoefte aan snelle en efficiënte interfaces tussen verschillende processors, memory pools en netwerkdomains. Fragmentatie aan de compute-kant kan daardoor meer waarde creëren aan de connectivity-kant.
Onze bullish visie vereist dus niet dat NVIDIA structureel verliest. Zij vereist dat de totale hoeveelheid AI-compute sterk blijft groeien, custom silicon een groter deel van die markt wordt en de connectivity-content per eenheid compute verder toeneemt. Die drie trends kunnen uitstekend tegelijkertijd plaatsvinden.
Zelfs $45–50 miljard in FY31 kan een zeer sterke uitkomst zijn
De bovenkant van $90 miljard omzet trekt vanzelfsprekend de meeste aandacht, maar voor de investment case is het nuttiger om een minder extreem scenario te modelleren. Wanneer Marvell in boekjaar 2031 bijvoorbeeld $45 miljard tot $50 miljard omzet zou realiseren, ligt dat ver onder de officiële bandbreedte maar nog steeds ruim boven de $20 miljard die voor FY28 wordt nagestreefd.
Vanaf $20 miljard komt een omzet van $45 miljard neer op ongeveer 31% jaarlijkse groei en $50 miljard op ongeveer 36%. Voor een semiconductorbedrijf van deze schaal zou dat nog steeds uitzonderlijk sterk zijn. Wanneer operating leverage tegelijkertijd verbetert, kan de winst per aandeel zelfs sneller stijgen dan de omzet.
Dit maakt de asymmetrie aantrekkelijk. De investment case hoeft niet afhankelijk te zijn van volledige realisatie van het managementkader. Het belangrijkste is dat Marvell vanuit de huidige basis naar een veel groter structureel winstniveau kan groeien, terwijl de officiële FY31-doelstelling extra upside vertegenwoordigt wanneer custom compute en connectivity beide sneller opschalen dan verwacht.
Wat wij vanaf nu per kwartaal willen zien
De eerste maatstaf blijft de route naar circa $20 miljard omzet in boekjaar 2028. Wij willen zien dat de onderliggende ramps groot genoeg zijn om deze verhoging niet alleen als aspiratie, maar als een steeds beter zichtbare financiële uitkomst te beschouwen. Dat betekent dat datacenteromzet, bookings en klantprogramma’s de komende kwartalen duidelijk moeten blijven versnellen.
Daarnaast wordt custom silicon belangrijker dan het aantal aangekondigde design wins doet vermoeden. De omzet moet over meerdere programma’s en klanten worden verspreid, terwijl bestaande wins aantoonbaar naar volume moeten gaan. Tegelijk willen wij zien dat XPU-attach materialiseert in echte productomzet en dat connectivity profiteert van hogere port speeds, grotere clusters en een stijgende hoeveelheid bandwidth per accelerator.
Ten slotte moet winstgevendheid meegroeien. Wanneer de omzet spectaculair stijgt maar incremental gross profit en vrije kasstroom achterblijven, wordt de kwaliteit van de groei minder aantrekkelijk. Wanneer Marvell daarentegen laat zien dat de combinatie van custom silicon en connectivity ook operationele hefboom creëert, kan de markt de onderneming uiteindelijk veel meer als een strategisch AI-platform waarderen.
De bullish kern: steeds meer Marvell-silicium rond iedere AI-processor
De belangrijkste conclusie uit de Investor Day is voor ons daarom niet één spectaculair omzetgetal. De echte verandering is dat Marvell probeert een steeds groter gedeelte van de volledige AI-architectuur te monetariseren. Custom XPUs brengen het bedrijf dichter bij de kern van compute, terwijl SerDes, switching, optics, memory connectivity en storage ervoor zorgen dat dezelfde onderneming ook kan verdienen aan de enorme hoeveelheid data die rond die compute moet bewegen.
Dat model kan bijzonder krachtig worden omdat de hoeveelheid connectivity en memory-infrastructuur per accelerator waarschijnlijk blijft stijgen. Meer compute creëert meer data, meer data vereist meer bandwidth en meer bandwidth verhoogt de waarde van efficiënte interconnect. Daardoor kan Marvell-content per systeem sneller toenemen dan het aantal processors zelf.
Wij hebben Marvell onlangs gekocht en de Investor Day maakt onze visie duidelijk sterker. De onderneming moet nog veel bewijzen op het gebied van execution, yield, margins en volume-ramp, maar de potentiële economische positie binnen AI-infrastructuur is aanzienlijk groter geworden. Wanneer Marvell de komende jaren laat zien dat het steeds meer silicium per XPU, per rack en per cluster kan leveren, kan het uitgroeien tot een van de centrale infrastructuurleveranciers van de volgende fase van AI.
Wil je alle artikelen kunnen lezen en elke podcast beluisteren? Neem dan een abonnement en krijg toegang tot alle artikelen en de database met duizenden berichten.
English version
Marvell sharply raises its outlook: custom silicon, XPU attach and interconnect make the AI thesis significantly stronger
■ Marvell has raised its fiscal 2028 revenue outlook from roughly $18 billion to approximately $20 billion and now presents a fiscal 2031 revenue framework of $70 billion to $90 billion. From the new FY28 target, that still implies roughly 52% to 65% compound annual growth, making clear that management expects a fundamentally larger role inside AI infrastructure.
■ Custom silicon is becoming one of the central growth engines. Marvell now expects more than $12 billion of revenue from this activity in fiscal 2029, while the true economic opportunity is larger because the same XPU programs can create demand for networking, memory connectivity, storage, security and other XPU-attached silicon.
■ The technical bottleneck in AI is increasingly shifting beyond raw compute toward data movement, memory bandwidth, latency, power and interconnect. This is precisely where Marvell's custom compute, SerDes, switching, optics and storage assets begin to converge.
■ Marvell's roughly $400 billion total addressable market should not be interpreted as automatic revenue. The more important variable is how much Marvell content can be captured per XPU, per rack and ultimately per cluster, because that creates the possibility of revenue growing faster than accelerator unit volumes alone.
■ We recently bought Marvell, and the Investor Day clearly strengthens our bullish view. Even if fiscal 2031 revenue ultimately falls well short of the top end of $90 billion, the combination of custom silicon, XPU attach and connectivity can create a much larger earnings base than investors would have considered realistic only a few years ago.
Investment View
We recently bought Marvell and view the Investor Day as a clear strengthening of the original investment thesis. The increase in the fiscal 2028 revenue outlook to approximately $20 billion matters, but the more important change is the way the company is attempting to expand its position inside the architecture of an AI data center. Marvell no longer wants to be valued as a supplier of individual networking and storage chips; it is increasingly positioning itself as a vendor of multiple critical silicon layers surrounding the same accelerator.
That transition changes the economics of a design win. If Marvell only supplies a custom XPU, revenue remains primarily tied to processor volumes and value per device. If the same customer relationship subsequently generates networking interfaces, memory controllers, storage controllers, switches, high-speed SerDes and additional attach products, the potential revenue per platform increases materially. Content per accelerator can therefore continue rising even if accelerator unit growth eventually starts to normalize.
Our view remains clearly bullish, but not because we treat $90 billion of fiscal 2031 revenue as a certainty. We primarily want Marvell to prove three things: that it can close the bridge toward roughly $20 billion of FY28 revenue, that custom silicon scales across several customers and programs, and that XPU attach becomes a material contributor to both revenue and profit. If those three developments occur simultaneously, Marvell's economic value can increase much faster than a traditional semiconductor model would suggest.
Marvell is not simply raising guidance, it is changing the scale of the company
Marvell generated approximately $8.2 billion of revenue in fiscal 2026 and is now outlining a path toward roughly $20 billion in fiscal 2028. Management then presents a fiscal 2031 framework of $70 billion to $90 billion. From $20 billion, the low end of that framework still requires roughly 52% annual growth while the upper end implies about 65%, an extraordinary pace for a company that would already be operating at considerable scale.
That growth cannot be explained by ordinary expansion in existing networking and storage businesses. To approach even the low end of the FY31 framework, several major custom compute programs need to ramp simultaneously, Marvell must sell more products around each XPU and connectivity content needs to keep growing faster than overall AI capital expenditure. Investor Day is therefore effectively a statement that management expects Marvell to capture a larger share of semiconductor content inside every new generation of AI systems.
This is why the increase toward approximately $20 billion in FY28 matters so much. The $70–90 billion FY31 framework is spectacular, but it is far enough away to depend on many variables that cannot yet be observed with precision. The FY28 target is close enough to be tested through quarterly bookings, product ramps, wafer commitments, customer concentration and data-center revenue. If Marvell closes that bridge convincingly, the credibility of the much larger long-term scenario rises automatically.
The real leverage is not simply XPU volume but content per XPU
Many analyses of custom silicon begin and end with the number of accelerators a supplier can win. For Marvell, we believe that framework is too narrow because every XPU sits inside a much larger system in which data must move between compute, memory, storage and networking. As accelerators become more powerful, the infrastructure required to keep those processors fully utilized becomes more complex as well.
The relevant variable is therefore not merely the number of XPUs produced but total Marvell content per XPU. If a new generation requires more high-speed links, greater memory bandwidth and more sophisticated network interfaces, semiconductor content per accelerator can rise without accelerator unit volumes growing at the same rate. This is precisely the type of multiplicative effect that can create a much steeper revenue curve than a simple unit-based analysis would imply.
For institutional investors, this matters because it reduces dependence on any single product category. A custom compute program can provide an entry point into multiple additional sockets and materially increase the lifetime value of a customer relationship. If Marvell can execute this attach strategy systematically, it creates a much broader revenue base than the central processor alone.
XPU attach could become the underestimated profit pool
The concept of XPU attach deserves considerably more attention than it typically receives. Surrounding a modern accelerator are network interfaces, memory controllers, storage controllers, security functions, fabric controllers and multiple forms of high-speed I/O. Each function represents separate semiconductor content and can become more complex and valuable with every new generation.
The economic opportunity arises because Marvell already owns technology across several of these domains. A customer using Marvell for custom compute can potentially use the same supplier for parts of its connectivity and memory architecture as well. That reduces integration risk for the customer while increasing the amount of Marvell content inside the same system, creating a more attractive model than competing for a single socket with a single ASP.
This attach logic becomes even more powerful as AI systems become increasingly heterogeneous. GPUs, custom accelerators, CPUs, memory pools and storage accelerators increasingly need to operate as one logical system. The more heterogeneous the compute architecture becomes, the greater the need for interfaces that connect those components efficiently. That is where Marvell can create more value than a simple accelerator-volume comparison would suggest.
Custom silicon is becoming a platform relationship rather than a discrete ASIC project
The expectation for more than $12 billion of custom silicon revenue in fiscal 2029 demonstrates how significant this business can become. Achieving that scale through one customer or one generation would be difficult, implying that management expects several programs to move toward significant production volumes at the same time. That matters because custom silicon becomes most attractive when individual design wins develop into recurring multi-generation relationships.
Hyperscalers have strong reasons to specify more of their own silicon. When a workload is sufficiently large and predictable, a custom accelerator can be optimized for specific data types, memory-access patterns, software stacks and power envelopes. At hyperscale, even a modest improvement in performance per watt can influence billions of dollars of infrastructure economics, making the incentive to develop proprietary architectures increasingly powerful.
At the same time, designing a successful custom chip is exceptionally difficult. The challenge involves not just compute logic but physical design, timing closure, high-speed I/O, memory interfaces, power delivery, thermal management, packaging and ultimately manufacturability on an advanced process node. A successful custom silicon vendor therefore becomes deeply embedded in the customer's roadmap, increasing the likelihood that a strong first generation leads to participation in the next architecture as well.
Engineering velocity becomes a competitive advantage
Technical quality alone is not sufficient in custom silicon. A chip arriving six months late can be commercially far less valuable because AI roadmaps now move extremely quickly and hyperscalers plan entire data-center deployments around predefined generations. Time to market is therefore a direct economic variable.
Marvell has indicated that a new design scaled to approximately 30,000 cores within sixty days and reached tape-out in less than nine months. To an outside observer, that may sound like an operational detail, but to a hyperscaler it is critical. The faster a supplier can move from architecture to first silicon without compromising quality, the greater the probability that the customer can meet its own product roadmap.
This also creates the potential for scale advantages. If Marvell can reuse IP, verification processes, packaging knowledge and physical-design workflows across different programs, engineering resources do not need to scale linearly with revenue. That becomes an important source of future operating leverage because revenue can grow faster than the cost base supporting the engineering organization.
The bottleneck is shifting from FLOPS toward data movement
The first phase of the AI investment cycle was largely about securing enough compute. The next phase increasingly concerns how efficiently that compute can be utilized. An accelerator may offer enormous theoretical performance, but that capacity has little economic value if weights, activations and intermediate results cannot be supplied quickly enough.
Memory bandwidth and interconnect bandwidth therefore become increasingly important. Data must move between compute and memory inside an accelerator, among processors within a server and eventually across clusters containing thousands or tens of thousands of devices. Every step in that scaling process increases the amount of data movement and raises the importance of latency and congestion.
Networking consequently becomes part of compute itself. If the fabric lacks sufficient bandwidth, accelerator utilization falls and returns on extremely expensive AI hardware deteriorate. For Marvell, this is structurally positive because the company does not necessarily need to win every accelerator if it can capture a larger share of the infrastructure connecting all those accelerators.
SerDes is not a detail but a fundamental asset
High-speed SerDes underpins a large part of modern data infrastructure. It converts parallel data into extremely fast serial streams and reconstructs those streams on the receiving side, but at hundreds of gigabits per lane this becomes an exceptionally difficult challenge involving signal integrity, jitter, equalization, bit-error rates and power consumption.
Each new generation becomes technically more demanding as lane rates increase. Channel loss rises, timing margins narrow and signal processing becomes more complex while hyperscalers simultaneously demand higher bandwidth and lower energy consumption per bit. A strong SerDes portfolio therefore becomes not merely a technical advantage but an economic asset governing how much data can move through a system and at what power cost.
For investors, picojoules per bit is an increasingly important measure. A difference of only a few picojoules may look insignificant at component level, but across a cluster moving enormous quantities of data continuously it can translate into a substantial system-level power difference. A more efficient interface can therefore create indirect capacity for additional compute within the same overall power budget.
Moving from 800G to 1.6T changes the entire physical layer
The transition from 800G to 1.6T should not be understood as simply doubling networking capacity. Higher data rates impose much tighter requirements on DSPs, modulation, equalization, lasers, thermal management and packaging, while total power per port cannot increase proportionally. The industry therefore needs to move more data while reducing energy per bit.
This creates a replacement cycle across the entire signal chain. Switches, DSPs, SerDes and optical components all need to support higher speeds, meaning that one networking generation can create semiconductor content at several points simultaneously. Marvell's opportunity is therefore driven by both the number of AI nodes and the amount of value embedded in each connection.
The same logic applies when the industry eventually moves toward 3.2T. Technical difficulty increases faster than nominal bandwidth alone would suggest, potentially increasing the value of proven high-speed IP while raising barriers to entry for smaller competitors.
Scale-up and scale-out require different technologies
AI networking is not one homogeneous market. Scale-up connects accelerators inside a tightly coupled compute domain and requires extremely low latency and very high bandwidth because several devices must behave as much as possible like one logical processor. Scale-out connects larger groups of servers, racks and pods and places greater emphasis on routing, congestion management, topology and reach.
In scale-up, the fabric increasingly becomes an extension of processor architecture. In scale-out, Ethernet, optical connectivity and very large switches are essential for keeping accelerator utilization high across greater distances. Both markets benefit from the same AI investment cycle, but their technical constraints and economic structures differ.
For Marvell, the attractive feature is the ability to participate across several layers. Custom compute, high-speed SerDes, switching and optics can all be deployed at different points within the same customer architecture, allowing the company to monetize both expansion of the compute domain and connectivity between separate domains.
Power is becoming the currency of AI infrastructure
The economic constraint in AI data centers is increasingly shifting from capital availability toward electrical availability. Hyperscalers may be willing to invest tens of billions of dollars, but if a site can only receive and cool a fixed number of megawatts, every watt becomes a scarce resource. Efficiency in networking and data movement therefore acquires much greater economic value.
A watt consumed by a switch, DSP or retimer cannot also be used for compute. A more efficient interface can therefore indirectly enable more accelerators inside the same building. The difference between two connectivity solutions should not be measured only through component price but through the total amount of compute that can be supported within a given power envelope.
This can change the economics of high-quality connectivity. Products that demonstrably deliver lower energy per bit are not commodities when they directly determine how much compute a hyperscaler can extract from the same electrical infrastructure. For Marvell, that can become a structural source of differentiation and pricing power.
Optics is moving progressively closer to the processor
Electrical connectivity remains highly effective over short distances, but the physics become increasingly unfavorable when speed and reach rise simultaneously. Signal loss increases, equalization becomes more complex and power consumption rises, pushing optical connectivity progressively closer to the compute layer.
Over time, this trend may lead to greater adoption of near-package and co-packaged optical architectures. In such systems, optics is no longer a peripheral networking module but an integral part of the way compute, memory and switches communicate. This increases the strategic value of optical DSPs, photonics and the interfaces surrounding them.
For Marvell, this matters because the company is already deeply positioned in high-speed connectivity. If optics structurally moves closer to the XPU, the amount of Marvell content per compute node can increase again, creating an additional route to grow faster than processor unit volumes alone.
Chiplets change the economics of advanced processors
As AI processors become larger, a monolithic die encounters both physical and economic limits. Larger dies have a lower probability of emerging from a wafer without defects and are also constrained by reticle limits. Chiplets provide a way to distribute functions across multiple smaller dies and even manufacture different components on different process nodes.
That can improve yield economics, but it shifts part of the technical challenge toward die-to-die connectivity. Those links need to move enormous quantities of data with very low latency and minimal power consumption. The package itself becomes a system in which connectivity can be nearly as important as the individual dies.
For Marvell, this creates two opportunities simultaneously. Custom compute can use more complex architectures without placing everything on one enormous die, while high-speed interface IP is required to make those chiplets operate as one logical processor. The boundary between compute and connectivity therefore begins to blur even inside the package.
Yield becomes a financial variable
Yield in advanced-node custom silicon is often treated as a technical detail, but for investors it is a direct earnings variable. If a large 3nm or 2nm die yields only a few percentage points below expectations, the effective cost per good chip can rise substantially. At millions of units, that difference can influence hundreds of millions of dollars in economics.
Poor yield can also delay a product ramp. For a hyperscaler that has already planned data-center capacity, software and power infrastructure around a new processor, delays may be far more expensive than the additional wafer cost itself. Reliable execution therefore carries enormous economic value.
This is both part of our bullish thesis and one of the key tests. Marvell must not simply keep announcing design wins; it must demonstrate that those designs can reach volume on advanced nodes with sufficient yield and on schedule. Ultimately, that conversion determines how much of the enormous TAM becomes real revenue.
Advanced packaging becomes as important as the wafer
The modern AI processor is increasingly no longer a single chip. Compute dies, HBM, I/O dies and other functions must be connected inside a complex package that directly affects bandwidth, thermal performance, power delivery and overall system performance.
This creates another bottleneck. Even when wafer yield is excellent, final package yield can still disappoint or advanced packaging capacity may be constrained. For custom silicon, supply-chain execution therefore becomes an integral part of the value proposition.
A hyperscaler does not simply want to know whether a chip works; it wants confidence that millions of devices can be delivered at the right time. Marvell therefore requires not only strong IP but sufficient access to foundry and packaging capacity to support very large ramps. As revenue ambitions increase, this operational dimension becomes increasingly important.
HBM and memory bandwidth determine how much compute can actually be utilized
AI workloads are becoming increasingly dependent on memory. An accelerator waiting for data consumes capital and electricity without fully monetizing its theoretical compute capacity. HBM bandwidth therefore becomes almost as important as the number of compute units on the processor.
At the same time, demand for memory capacity is expanding. Large models, longer context windows and agentic workloads can keep enormous quantities of data active, making it economically impractical to place everything in the fastest memory adjacent to the accelerator. This creates an increasingly complex hierarchy of HBM, DRAM, pooled memory and storage.
That again raises the importance of controllers and connectivity. Data must move efficiently between different tiers while the architecture prevents expensive compute resources from sitting idle. For Marvell, this is attractive because memory, storage and networking increasingly converge, making multiple parts of the portfolio relevant within the same system architecture.
Revenue is not enough: revenue quality becomes decisive
For an institutional investor, $70 billion to $90 billion of revenue is impressive but insufficient on its own. The true question is how much gross profit, operating income and free cash flow that revenue generates. Custom silicon in particular needs to be evaluated through the relationship among volume, ASP, NRE, gross margin and the engineering expense required to support each program.
Custom products may carry lower percentage gross margins than highly differentiated merchant silicon while still generating significantly greater absolute gross profit. A declining gross-margin percentage is therefore not automatically negative if gross profit and operating income grow much faster. What matters is the incremental profitability produced by each additional dollar of revenue.
This becomes a major test for Marvell. If revenue expands rapidly while R&D and other operating expenses rise much more slowly, the company can generate powerful operating leverage. If every new customer requires nearly proportional engineering resources, that leverage becomes weaker and investors will assign a lower valuation multiple to the growth.
NRE, ASP and wafer volume determine the economic quality of custom silicon
A custom design win is not yet production revenue. Between an initial agreement and large wafer volumes sit architecture freeze, verification, physical design, tape-out, silicon bring-up, qualification and full system validation. Each stage introduces technical and commercial risk.
NRE can offset part of development cost, but the major economic value only appears when a product reaches volume production. Investors therefore need to distinguish between announced wins and proven production ramps. Particularly in a strong AI market, valuation can easily move ahead of revenue that remains several technical milestones away from mass production.
The upside is that revenue can accelerate very quickly after qualification. Once a hyperscaler commits to deploying hundreds of thousands or millions of devices, a program can move from engineering activity to billions of dollars of product revenue in a relatively short period. This helps explain why Marvell's custom silicon growth over the next several years may be highly non-linear.
The $400 billion TAM needs to be interpreted critically
Marvell's roughly $400 billion total addressable market is impressive, but a TAM is not a forecast. The useful analysis begins by separating that market into custom compute, interconnect, switching, storage and other attach products, then assessing where Marvell has genuine technological differentiation and what market share can realistically be won.
The bullish element is therefore not the absolute TAM figure. It is the possibility that several portions of that TAM converge inside the same customer architecture. If Marvell wins only custom compute, the opportunity remains substantial but clearly bounded. If the same compute relationship also produces networking, storage and memory-connectivity revenue, potential customer value rises much faster.
That is why we interpret Investor Day more positively than a simple guidance increase. Management is effectively describing a strategy designed to capture a progressively larger share of each hyperscaler's total semiconductor wallet.
Broadcom remains the reference, but Marvell does not need to replace Broadcom
Broadcom remains the key benchmark for valuing custom AI silicon. It has enormous scale, deep hyperscaler relationships, proven execution and significant technology in networking and SerDes. Marvell has not yet demonstrated the same level of commercial scale.
However, Marvell does not need to displace Broadcom outright for the thesis to work. The overall market can become large enough for multiple suppliers to generate very substantial revenue, while hyperscalers also have strategic incentives to diversify suppliers, architectures and IP. Different vendors can even win different sockets inside the same infrastructure.
The true competition is therefore for wallet share across the full architecture. If Marvell can use existing custom compute relationships to sell more connectivity, memory and storage products, revenue per customer can increase significantly without the company needing to lead every individual product category.
NVIDIA does not have to lose for Marvell to win
The rise of custom silicon is often framed as a direct threat to NVIDIA, but that framing is too simplistic. The AI market can become large enough for both NVIDIA platforms and multiple custom XPU architectures to grow strongly. Different workloads also require different solutions.
For Marvell, that heterogeneity can actually be beneficial. The greater the number of compute architectures, the stronger the need for high-speed, efficient interfaces among different processors, memory pools and network domains. Fragmentation on the compute side can therefore create more value on the connectivity side.
Our bullish thesis does not require NVIDIA to structurally lose share. It requires total AI compute to keep expanding, custom silicon to become a larger part of that market and connectivity content per unit of compute to keep increasing. All three trends can occur simultaneously.
Even $45–50 billion in FY31 could still be an exceptional outcome
The $90 billion upper end naturally attracts the most attention, but a less extreme scenario is more useful for analyzing the investment case. If Marvell were to generate, for example, $45 billion to $50 billion of revenue in fiscal 2031, that would be far below management's official framework but still dramatically above the approximately $20 billion targeted for FY28.
From $20 billion, $45 billion implies roughly 31% annual growth while $50 billion implies approximately 36%. For a semiconductor company of this scale, that would still be exceptional. If operating leverage improves at the same time, earnings per share could grow faster than revenue.
This makes the asymmetry attractive. The investment thesis does not depend on full realization of management's framework. The key point is that Marvell can move from its current base toward a structurally much larger earnings level, while the official FY31 framework provides additional upside if both custom compute and connectivity scale faster than expected.
What we want to see each quarter from here
The first measure remains the path toward approximately $20 billion of fiscal 2028 revenue. We want the underlying ramps to become large enough that this target increasingly looks like a visible financial outcome rather than an aspiration. That means data-center revenue, bookings and customer programs need to continue accelerating over the coming quarters.
Custom silicon must also become more important than the number of announced design wins suggests. Revenue needs to broaden across several programs and customers while existing wins demonstrably convert into volume. At the same time, XPU attach needs to become real product revenue and connectivity needs to benefit from higher port speeds, larger clusters and rising bandwidth per accelerator.
Finally, profitability must scale with revenue. If sales grow spectacularly while incremental gross profit and free cash flow lag, the quality of the growth deteriorates. If Marvell instead proves that the combination of custom silicon and connectivity generates operating leverage, the market may ultimately value the company much more like a strategic AI infrastructure platform.
The bullish core: more Marvell silicon around every AI processor
The most important conclusion from Investor Day is therefore not one spectacular revenue number. The real change is that Marvell is attempting to monetize an increasingly large portion of the full AI architecture. Custom XPUs move the company closer to the center of compute, while SerDes, switching, optics, memory connectivity and storage allow Marvell to capture value from the enormous quantity of data moving around that compute.
This model can become particularly powerful because connectivity and memory infrastructure per accelerator are likely to keep increasing. More compute creates more data, more data requires more bandwidth and more bandwidth raises the value of efficient interconnect. Marvell content per system can therefore rise faster than processor unit volumes alone.
We recently bought Marvell, and Investor Day makes our view materially stronger. The company still has a great deal to prove in execution, yield, margins and volume ramps, but its potential economic position inside AI infrastructure has become significantly larger. If Marvell demonstrates over the coming years that it can capture progressively more silicon per XPU, per rack and per cluster, it can become one of the central infrastructure suppliers of the next phase of AI.
Wil je alle artikelen kunnen lezen en elke podcast beluisteren? Neem dan een abonnement en krijg toegang tot alle artikelen en de database met duizenden berichten.
Disclaimer Aan de door ons opgestelde informatie kan op geen enkele wijze rechten worden ontleend. Alle door ons verstrekte informatie en analyses zijn geheel vrijblijvend. Alle consequenties van het op welke wijze dan ook toepassen van de informatie blijven volledig voor uw eigen rekening.
Wij aanvaarden geen aansprakelijkheid voor de mogelijke gevolgen of schade die zouden kunnen voortvloeien uit het gebruik van de door ons gepubliceerde informatie. U bent zelf eindverantwoordelijk voor de beslissingen die u neemt met betrekking tot uw beleggingen.


